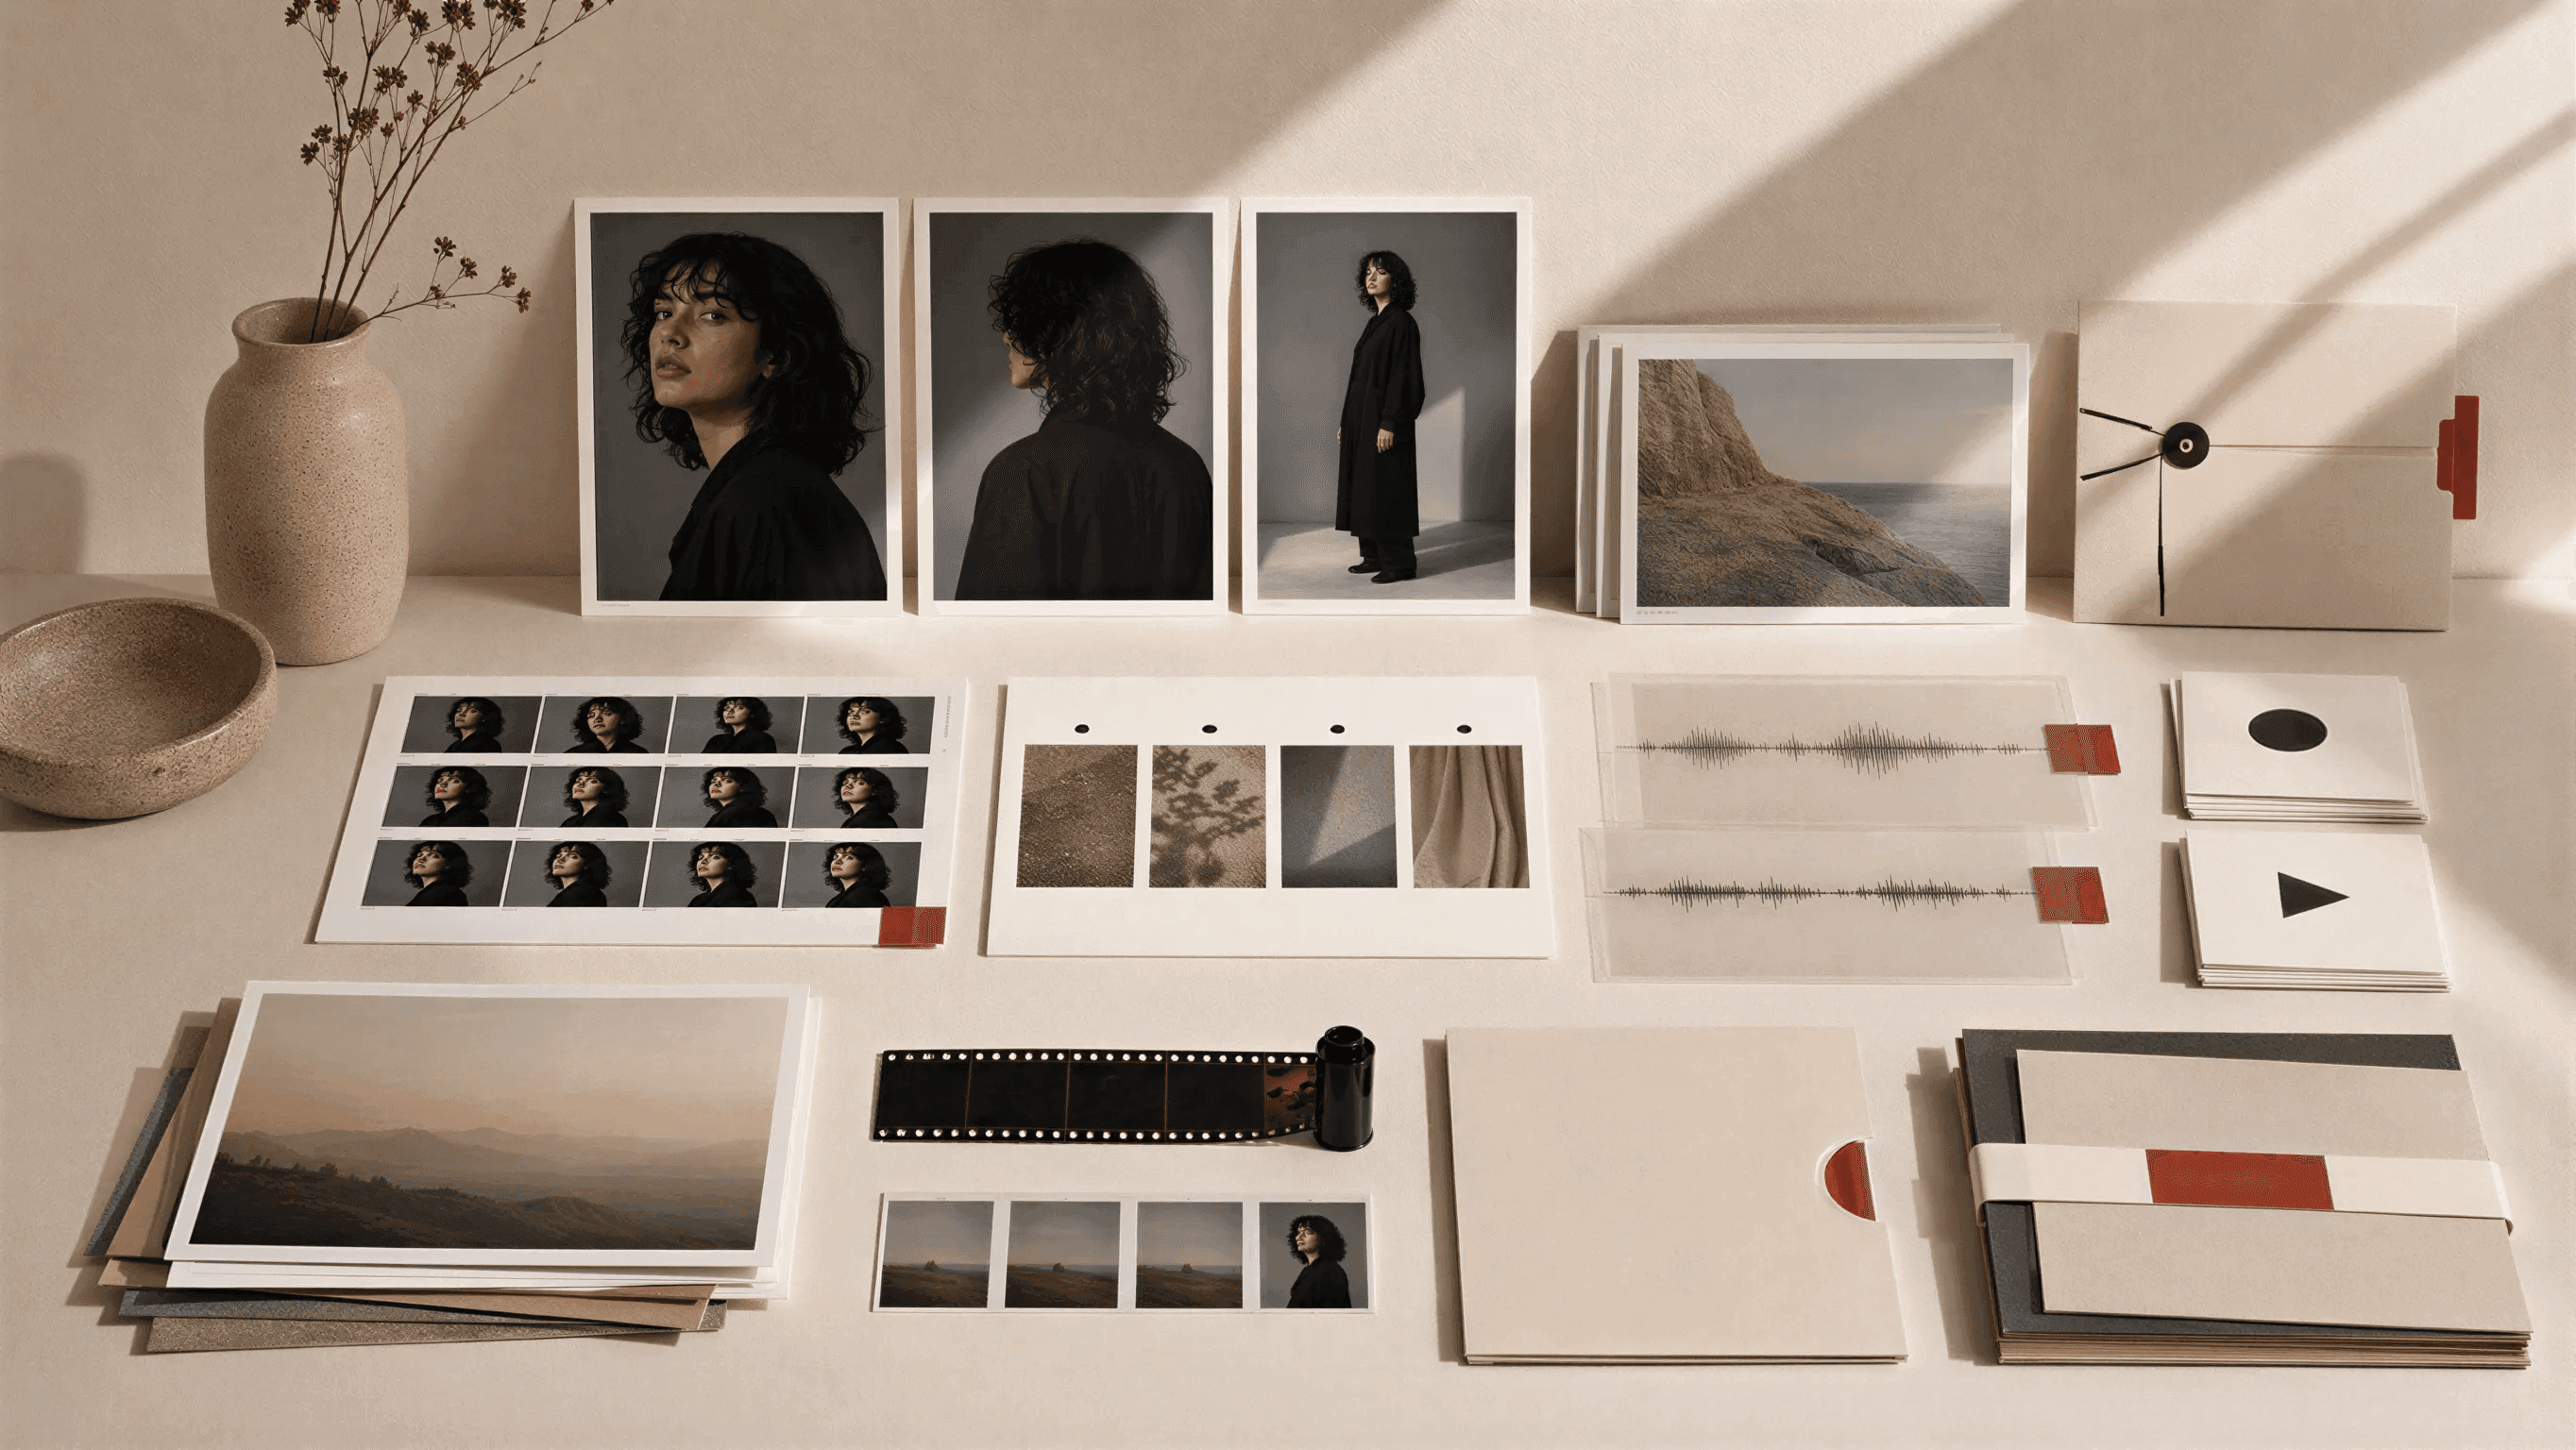
모큐멘터리는 인터뷰, 하드 컷, 핸드헬드 구도, 짧은 B롤을 각각 만들 수 있어 AI 영화 제작에 적합합니다. 제가 첫 편집본에 적용하는 기준은 모든 샷이 인물을 드러내거나 이야기를 진행하거나 편집점을 가려야 한다는 것입니다. 어느 역할도 하지 못한다면 생성 목록에서 뺍니다.
모큐멘터리가 장면별 AI 작업에 적합한 이유
대부분의 AI 영상 형식에서는 실수가 치명적입니다. 천천히 움직이는 영화적 샷이 흔들리거나, 프레임 사이에서 얼굴이 달라지거나, 움직이는 도중 조명이 바뀌면 정교한 드라마나 액션 장면의 몰입감이 깨집니다.
모큐멘터리는 이를 뒤집습니다. 모든 ‘결함’에는 그럴듯한 설명이 붙습니다.
- 손으로 들고 흔들며 잡은 화면은 AI 오류가 아니라 실제 다큐멘터리 영상처럼 보입니다
- 하드 컷은 불완전한 전환을 숨기므로 클립 사이의 이음새를 매끄럽게 만들 필요가 없습니다
- 인터뷰 화면에는 영화 같은 카메라워크가 필요 없습니다. 얼굴과 일관된 표정만 있으면 됩니다
- 짧은 클립은 통제 비용이 적고, 잘못되어도 다시 생성하는 비용이 적습니다
이 형식은 날것 그대로의 약간 불완전한 영상이 매끈하게 다듬은 영상보다 더 믿을 만하다는 논리를 바탕으로 합니다. AI 영상 생성은 바로 그런 영상을 만들어 냅니다.
통제해야 할 것은 캐릭터의 일관성과 편집뿐입니다. 나머지는 이 형식이 알아서 해결해 줍니다.
생성 전에 계획하기
DomoAI를 열기 전에 인터뷰의 주요 전개 5–8개를 적으세요. 전개 하나는 한 장면에서 인물이 말하거나 행동하는 내용을 한 문장으로 설명한 것입니다.
- “마야는 자신과 아무 관련이 없다고 주장한다.”
- “로버트가 회사 방침을 천천히 설명한다.”
- “화면에 나오지 않는 목소리로 해설하는 사건 영상.”
이 이야기의 전개점들이 곧 영화입니다. 완성된 대본은 필요 없습니다. 등장인물이 누구인지, 어떤 관점을 가졌는지, 이야기가 어떤 순서로 펼쳐지는지 알 수 있을 정도면 됩니다.
전개 목록은 인터뷰 클립 목록과 B롤 체크리스트가 됩니다. 맡은 전개가 없는 인물은 생성할 필요가 없습니다. 전개가 없는 장면도 필요하지 않습니다.
전개부터 쓰세요. 계획에 있는 인물만 생성하고 나머지는 Assets 패널에 넣지 않습니다. 이 기준은 클립 수를 관리 가능한 수준으로 유지하고 편집 시간이 자료 찾기로 바뀌는 것을 막아 줍니다.
전개점은 아직 갖추지 못한 구조도 드러냅니다. 모든 전개점이 한 인물의 것이라면 모큐멘터리가 아니라 독백입니다. 인물 다섯 명에 전개점 열두 개라면 제작상의 문제가 생깁니다.
소규모 출연진과 짧은 전개 목록은 프로젝트를 검토하기 쉽게 만듭니다. 사용할 수 있는 시간과 생성 예산에 맞춰 인터뷰, 반응 삽입 샷, B롤을 계획하세요.
1단계: 출연진부터 확정하기
캐릭터 일관성은 모큐멘터리의 성패를 가르는 단 하나의 변수입니다. 다른 일을 하기 전에 등장인물을 생성하고, 참조 이미지를 정한 뒤에는 절대 벗어나지 마세요.
Nano Banana Pro로 일관된 인물을 만드는 방법:
- 참조 이미지를 최대 9장 업로드하세요. 실제 사진이 있다면 사용하세요. 처음부터 생성한다면 3~4개 변형을 만들고 가장 일관된 얼굴을 선택하세요.
- 생성 프롬프트 예시: “다큐멘터리 출연자, 30대 초반, 약간 흐트러진 비즈니스 캐주얼, 자연스러운 실내 빛, 미디엄 샷, 조금 지친 표정, 사실적”
- 정면 인물 사진, 미디엄 샷, 약간 돌아선 3/4 각도, 세 가지를 생성하세요. 세 이미지 모두 Assets 패널에 저장하세요.
- 반복 등장할 인물마다 같은 과정을 진행하세요. 설득력 있는 모큐멘터리에는 인터뷰 대상 두세 명이면 충분합니다.
인물의 일관성을 깨뜨리는 요소:
극단적인 얼굴 각도는 일관성을 깨뜨립니다. 정면 참조로 만든 인물을 완전한 측면으로 보여 주면 외모가 달라집니다. 모델이 그 각도를 처음부터 만들어 내야 하기 때문입니다. 인물의 각도는 참조에서 30도 이내로 유지하세요.
의상 변화는 연결을 깨뜨립니다. 이야기 속 설명 없이 한 장면에서 정장을 입고 다음 장면에서 티셔츠를 입으면 다른 사람처럼 보입니다. 참조 이미지에서 의상을 정하고 이야기상 꼭 필요한 변화가 아니라면 일관되게 유지하세요.
대부분의 모큐멘터리 단편에는 반복해서 등장하는 인물 두세 명이 적당합니다. 한 명이면 독백이고, 네 명 이상이면 관리하기 어려워집니다.
Character to Video는 고정한 인물의 외모를 유지하면서 새로운 움직임을 부여합니다. 클립 사이의 조명과 구도를 일정하게 유지해 모든 장면이 한 번의 촬영에서 나온 것처럼 보이게 하세요.
출연진의 시각적 기준 정리하기
저는 반복 등장하는 인물마다 표의 한 행을 씁니다. 모든 동작 프롬프트에 전체 인물 설명을 붙여 넣는 것보다 유용합니다.
| 고정할 항목 | 한 번 기록할 내용 | 클립마다 검토할 내용 |
|---|---|---|
| 얼굴 | 승인한 포트레이트와 표정 범위 | 눈, 턱, 헤어라인 |
| 의상 | 색상, 재단, 액세서리 | 누락되거나 바뀐 세부 요소 |
| 소품 | 특징적인 물건과 잡는 손 | 크기와 몸의 어느 쪽에 있는지 |
| 장소 | 배경 이미지와 빛의 방향 | 창문, 화면 속 광원, 수평선 |
| 구도 | 인터뷰, 미디엄 또는 전신 | 장면에 의도한 역할과 맞는지 |
| 목소리 | 화자 파일, 속도, 감정 | 화면 없이도 같은 인물로 알아볼 수 있는지 |
AI 스토리보드 가이드는 전개표를 필요한 촬영 구성으로 바꾸는 데 유용합니다. 여러 인물의 예시는 세 캐릭터가 등장하는 시트콤 장면을 살펴보고, 더 넓은 이야기 아이디어는 스토리 동영상 모음에서 찾아보세요.
2단계: 인물 인터뷰 만들기
인물 인터뷰는 모큐멘터리의 중심입니다. 이야기를 전달하고 농담을 풀어내며 다른 화면으로 전환할 기준이 됩니다. 이 부분부터 생성하세요.
Talking Avatar에 고정한 캐릭터 이미지와 오디오를 업로드하세요. 표준 요금제에서는 5초, 10초, 20초를 선택할 수 있고, Pro에서는 30초와 60초 클립을 사용할 수 있습니다. 독백이 아니라 짧은 인터뷰 답변을 작성하세요. 클립마다 10~15초의 대사를 넣으면 자연스럽게 이어집니다.
먼저 Text to Speech에서 음성을 생성하세요. [Cheerful] 같은 감정 태그는 TTS 대본에 적용합니다. 그런 다음 오디오를 Talking Avatar로 보내고 별도의 동작·표정 프롬프트로 미소, 끄덕임, 시선, 몸짓을 지시하세요.
[Neutral] — 차분하고 신중한 답변[Sad] — 고백하거나 마지못해 인정하는 순간[Surprised] — 새로운 사실의 공개 또는 반응[Angry] — 점점 격해지는 언쟁
표정과 동작 프롬프트는 대본과 별도로 입력하세요.
- “조금 긴장한 미소, 잠깐 카메라 밖을 봄, 의자에서 자세를 바꿈”
- “팔짱을 낌, 의심스러운 표정, 한쪽 눈썹을 올림”
- “몸을 살짝 앞으로 기울임, 집중하는 모습, 천천히 끄덕임”
- “아래를 봤다가 다시 올려다봄, 대답하기 전 불편한 침묵”
- “자신감 있는 모습, 직접적인 눈맞춤, 모은 손, 살짝 든 턱”
- "trail off mid-thought, eyes move to corner, recover with a tight smile"
캐릭터 표현으로 활용하는 TTS 속도: 복제 음성의 속도 조절 범위는 0.5배~2.0배입니다. 약간 느린 말투(0.85배)는 신중하게 말하는 느낌을 주어 고백하거나 조심스러운 인물처럼 들립니다. 약간 빠른 말투(1.1배)는 긴장하거나 회피하는 느낌을 줍니다. 속도를 단순한 템포 조절이 아니라 캐릭터 표현에 활용하세요.
중요한 대사에 대해서만 대체 테이크를 생성하세요. Talking Avatar는 Fast Mode로 실행되므로 재시도할 때 크레딧이 소모됩니다.
3단계: B롤과 삽입 샷 생성하기
B롤은 이어지는 인터뷰 화면을 끊어 주고 작품 속 세계에 질감을 더합니다. 실제 다큐멘터리에서 B롤은 편집점을 가리고 장면을 확장합니다. 여기서는 클립 사이의 연속성 문제도 숨겨 줍니다.
1. 장소 소개 샷: 생성한 정지 이미지에 Image to Video(Seedance 2.0)를 사용하세요. 프롬프트: "empty office hallway, fluorescent lights, late afternoon, slightly desaturated, handheld look"
2. 반응 삽입 샷: 소리 없이 화면 밖을 바라보는 인물을 찍으세요. 표정만 보여 주면 됩니다. Talking Avatar 표정 전용 프롬프트: "subject watches something out of frame, slight discomfort, handheld medium shot"
3. 물건과 디테일 삽입 샷: 정지 이미지를 만든 뒤 움직이세요. 프롬프트: “어질러진 책상 위 서류 더미, 옆에 놓인 펜, 다큐멘터리 클로즈업, 자연스러운 창문 빛, 약간의 카메라 이동”
4. 움직이는 인물: 걷는 참조 클립과 함께 Character to Video를 사용하세요. 지시: “카메라에서 멀어지며 복도를 걸어가는 사람, 핸드헬드 추적 샷, 조금 흔들림”
5. 기록물 또는 발견된 영상 스타일: 거친 필름 입자, 바랜 색, 약간 불안정한 구도의 짧은 클립을 생성하세요. 이런 삽입 영상은 세계에 깊이를 더하고 현재 사건 너머의 역사를 암시합니다. 프롬프트: "16mm film look, heavy grain, slight colour fade, institutional office hallway, 1990s, unsteady handheld"
6. 카메라에 직접 말하는 고백 장면: 정식 인터뷰 의자가 아니라 카메라에 갑자기 포착된 인물입니다. Talking Avatar 프롬프트: "caught mid-task, slightly startled by camera, recovers to direct address, documentary veríté"
DomoAI 2.4.1의 Frames to Video는 키프레임 2~8장과 1~56초의 멀티프레임 생성을 지원합니다. 반면 Seedance 2.0의 Frames to Video는 시작 프레임과 끝 프레임을 사용하며, Seedance의 4~15초 범위를 따릅니다.
4단계: 짧은 클립을 편집기에서 영화로 조립하기
영화는 개별 클립이 아니라 타임라인에서 완성됩니다. 완성도가 낮은 3초짜리 삽입 샷은 거의 비용 없이 다시 만들 수 있습니다. 불필요하게 긴 45초짜리 인터뷰 클립은 고치기 어렵습니다.
클립 유형별 목표 길이:
- 인터뷰 답변: 5–20초
- 반응 삽입 샷: 3–8초
- 장소 소개 샷: 5–10초
- 디테일 삽입 샷: 2–5초
CapCut, Premiere Pro 또는 DaVinci Resolve에서 편집하세요. 침묵할 때가 아니라 말하는 중에 자르세요. 모큐멘터리의 리듬은 짧고 약간 불안합니다. 한 박자 일찍 느껴지는 컷이 대개 잘 맞습니다.
5단계: 편집기에서 다큐멘터리 느낌 더하기
마무리 작업은 각각의 클립이 한 영화처럼 느껴지는지에 큰 영향을 줄 수 있습니다. 시퀀스 전체에서 이름 자막, 자막 스타일, 실내 배경음, 입자, 색 처리를 일관되게 유지하세요.
이름 자막: 왼쪽 아래에 흰색 산세리프 글자를 넣으세요. 표기는 ‘이름, 직함’입니다. 이 요소 하나로 카메라를 보며 말하는 모든 화면이 인터뷰처럼 보입니다. CapCut에는 이름 자막 템플릿이 내장되어 있습니다. Premiere Pro에서는 Essential Graphics 패널을 사용하세요.
캡션과 자막: CapCut이나 Premiere Pro에서 음성으로 자동 생성하세요. 명확한 허구의 모큐멘터리도 자막의 도움을 받습니다. 시청자가 계속 보게 돕고 다큐멘터리의 시각적 표현을 더합니다.
내레이션: Text to Speech로 생성하세요. Neutral이나 약간 지친 목소리를 사용합니다. 인터뷰 위가 아니라 B롤과 장소 소개 샷 아래에 놓으세요. 장면을 넘길 때 한두 문장으로 짧게 유지하세요.
색 보정: 채도를 약 20% 낮추세요. 필름 입자를 조금 넣고 미묘한 비네트를 추가하세요. 이 조합은 즉시 ‘기록물’이나 ‘실제 영상’처럼 느껴집니다. 생략하지 마세요.
음악과 실내 배경음: 편집된 영상 아래에 낮은 볼륨의 지속적인 환경음이나 간소한 음악을 깔아 주세요. Suno는 반복 재생하기 좋은 짧은 곡을 만드는 데 적합합니다. 편집점 사이의 실내 배경음은 이어 붙인 클립을 단절되게 느끼게 하는 침묵을 메웁니다. 0.5초의 환경음만으로도 하드 컷이 부드러워집니다.
제가 계획할 30초짜리 콜드 오프닝
| 시간 | 샷 | 이야기 속 역할 |
|---|---|---|
| 0–4초 | 고정된 인터뷰: ‘프린터가 회의를 시작했어요.’ | 황당한 전제를 제시 |
| 4–7초 | 프린터의 핸드헬드 클로즈업 | 시각적 증거 제공 |
| 7–13초 | 두 번째 직원이 책임을 부인함 | 갈등 형성 |
| 13–18초 | 보안 영상 스타일의 복도 삽입 샷 | 인터뷰 사이의 전환을 가림 |
| 18–25초 | 관리자가 인쇄된 요구 사항 더미를 공개함 | 농담을 한 단계 확대 |
| 25–30초 | 무언의 반응 뒤 타이틀 카드 | 마지막 웃음이 전달될 여유를 줌 |
이는 속도감의 예시 하나이며 모든 영상에 적용되는 길이 규칙이 아닙니다. 얼굴이 달라지면 저는 인터뷰 샷을 다시 생성합니다. 농담이 늦게 나오면 편집합니다. 문자나 로고가 틀리면 생성 영상 밖에서 고칩니다. 전환이 갑작스럽다면 하드 컷을 살리거나 Frames to Video로 계획합니다.
카메라 선택에는 동작 제어 가이드가 의도한 핸드헬드의 활력과 우발적인 흔들림을 구분하는 데 도움이 됩니다. 단편이 여러 장면으로 늘어나면 영화 제작자 워크플로 페이지가 더 넓은 다음 단계가 됩니다.
최종 편집본 다듬기
인터뷰와 B롤의 균형: 이야기를 전달할 충분한 인터뷰를 사용하고, 반응, 모순, 배경의 디테일, 시각적 농담이 정보를 더할 때 다른 화면으로 전환하세요. 고정된 비율보다 명확성과 속도감으로 균형을 판단합니다.
편집이 막히면 다른 것을 바꾸기 전에 비율부터 확인하세요.
장면 길이: 정보나 감정의 전개가 바뀔 때 자르세요. 반응, 장소의 디테일, 앞선 말과 모순되는 B롤은 모든 장면의 길이를 같게 맞추지 않고도 주의를 새롭게 끌 수 있습니다.
인터뷰 시퀀스의 3단계 법칙: 인터뷰 시퀀스는 보통 세 부분으로 이루어집니다. 첫 클립은 입장을 정하고, 두 번째는 증거나 반박을 제시하며, 세 번째는 반응이나 결과를 보여 줍니다. 인터뷰 시퀀스를 세 개씩 구성하면 대본이 간단해도 이야기에 구조가 생깁니다.
타이틀 카드 배치 위치: 첫 인터뷰 전에 10~15초의 B롤이나 장소 소개 화면으로 시작하세요. 그 소개 화면이 시작된 지 8~12초에 타이틀 카드를 넣으세요. 관객은 제목을 보고 지금까지 본 내용을 확인할 만큼의 맥락을 얻은 상태입니다.
AI 모큐멘터리가 편집에서 흔히 무너지는 지점: 가장 흔한 실패는 같은 인물의 인터뷰 클립을 너무 많이 연속으로 배치하는 것입니다. 한 사람의 클립 세 개가 삽입 샷 없이 이어지면 인터뷰가 아니라 독백처럼 보입니다.
인터뷰 클립 두세 개마다 반응 샷이나 B롤을 넣거나 다른 인물로 전환하세요. 삽입 샷은 길 필요가 없습니다. 종이 더미나 복도를 3초만 보여 줘도 리듬이 초기화되고 다음 인터뷰 클립에 새로운 추진력이 생깁니다.
자주 묻는 질문
DomoAI로 영화 전체를 한 번에 생성할 수 있나요? 아니요. 의도된 설계입니다. 한 번에 길게 생성할수록 통제하기 어렵고 모습이 달라질 가능성이 커집니다. 짧고 통제된 클립을 이어 붙여 영화를 만듭니다. 한 번의 긴 생성보다 연기, 속도감, 캐릭터 일관성을 더 정밀하게 조절할 수 있습니다.
장면마다 인물의 일관성을 유지하려면 어떻게 하나요? 무엇이든 생성하기 전에 Assets에서 캐릭터 참조를 고정하세요. 그 인물의 모든 클립은 같은 저장 이미지를 참조해야 합니다. Nano Banana Pro에서는 최대 9장의 참조로 안정적인 인물을 만들 수 있습니다. 정면, 미디엄 샷, 3/4 각도를 기본으로 사용하세요.
AI 모큐멘터리를 사실적으로 보이게 하는 요소는 무엇인가요? 세 가지입니다. 일관된 인물, 올바른 다큐멘터리 구도(인터뷰 화면, 핸드헬드 B롤, 이름 자막), 가벼운 입자를 더한 낮은 채도의 색 보정입니다. 장면 사이에서 얼굴이 달라지거나 클립끼리 시각적 문법이 다르면 몰입이 깨집니다.
긴 클립이 짧은 클립보다 더 나빠 보이는 이유는 무엇인가요? AI 영상 생성은 시간이 지날수록 변화가 누적됩니다. 30초 클립에는 10초 클립보다 얼굴이 미묘하게 달라지거나 움직임이 잘못되거나 조명이 바뀔 기회가 더 많습니다. 짧은 클립은 통제력을 줍니다. 길이는 편집으로 이어 붙여 만듭니다.
모큐멘터리 단편을 완성하는 데 얼마나 걸리나요? 제작 시간은 등장인물 수, 클립 수, 재시도, 편집에 따라 달라집니다. 인물을 고정하고, 인터뷰와 B롤을 생성하고, 소리와 타임라인을 마무리하는 시간을 각각 따로 잡으세요.
완성한 AI 모큐멘터리는 얼마나 길어야 하나요? 누구에게나 맞는 이상적인 길이는 없습니다. 이야기를 완결하는 가장 짧은 버전부터 시작하고, 새로운 전개점이나 반응, 증거를 제공할 때만 장면을 추가하세요.
전체 대본을 써야 하나요? 아니요. 인터뷰 전개점 5~8개를 각각 한 문장으로 쓰고 대략적인 B롤 목록을 만드세요. 각 인터뷰 클립의 실제 대본은 TTS에서 발전시킬 수 있습니다. 2~3문장짜리 답변을 쓰고 생성한 뒤 잘 맞는지 확인하세요. 대본보다 전개점이 중요합니다.
유료 요금제가 필요한가요? 무료 요금제로 캐릭터 생성과 짧은 클립을 시험할 수 있습니다. 더 긴 Talking Avatar 클립(30초, 60초)과 더 많은 생성량에는 유료 요금제가 필요하며, 연간 결제 시 월 $6.99부터 시작합니다.
DomoAI의 제한된 무료 체험으로 시작하고, 더 긴 영화를 생성하기 전에 현재 요금제의 제한을 확인하세요.