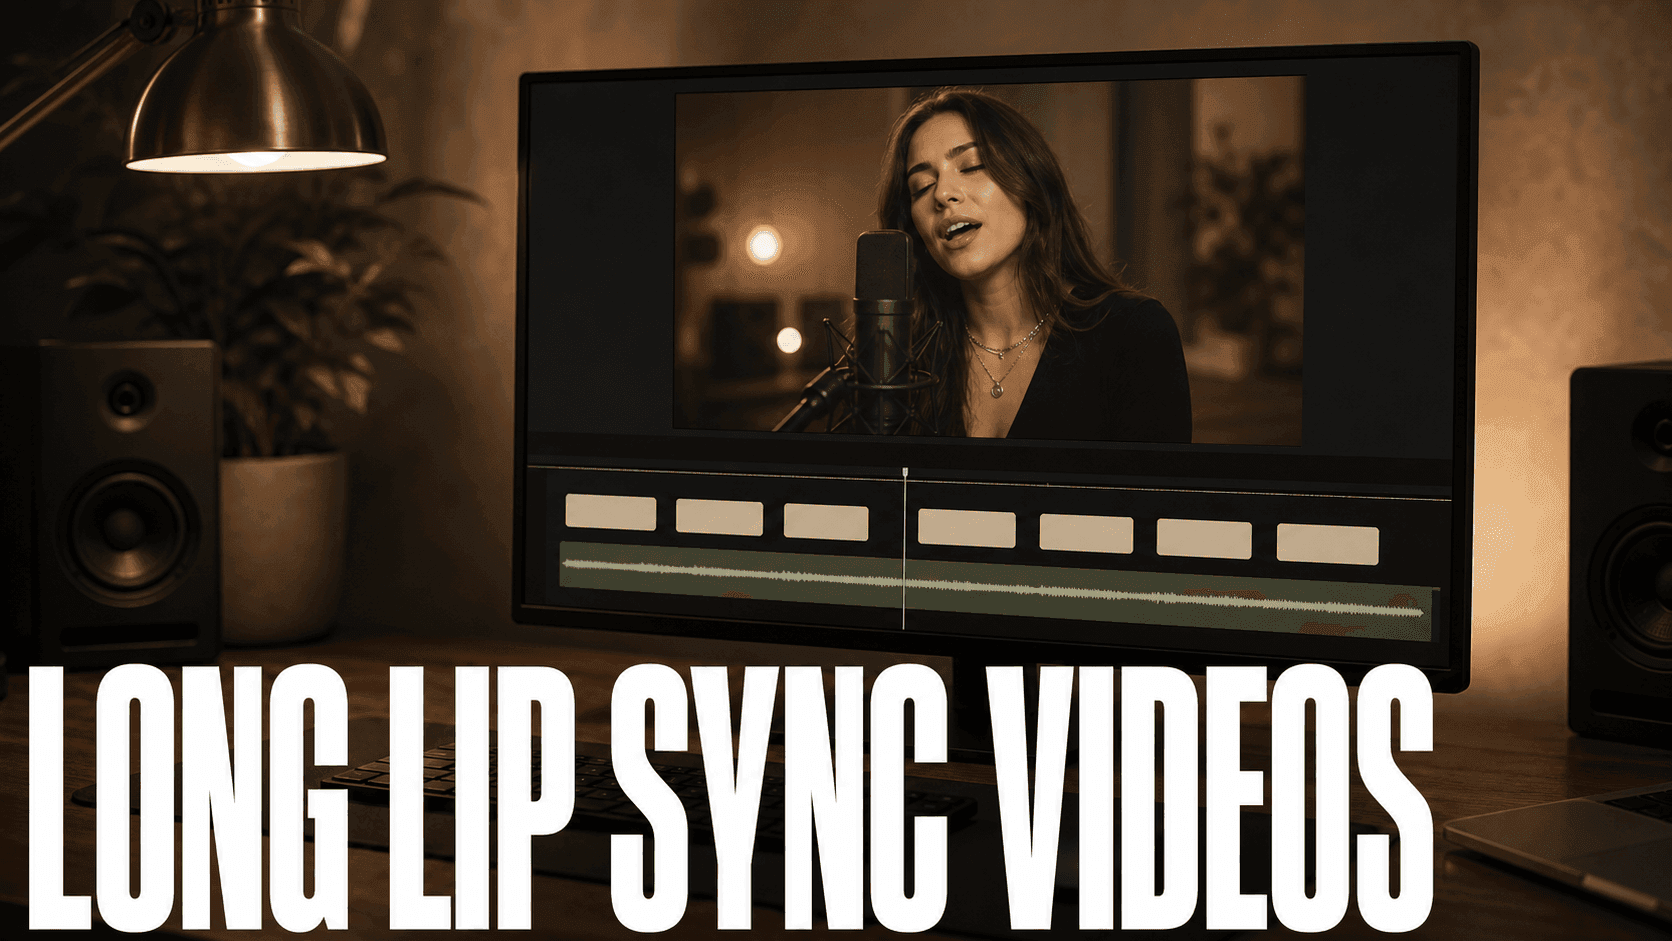
把歌曲拆成短人聲段落,用穿插鏡頭覆蓋難同步的歌詞,再於剪輯軟體中組合完整表演,就能製作較長的 AI 嘴型同步音樂影片。我會先把它當成剪輯專案來規劃:先做副歌,再決定哪些位置真的需要持續看見嘴巴。
把歌曲當成時間軸,而不是一次漫長的生成。
我的原則是只在觀眾可能仔細看嘴巴的位置投入嘴型同步製作,例如副歌的吸耳句、長音與情緒特寫。節奏、轉場、間奏,以及修復成本過高的歌詞,則使用非歌唱鏡頭。
簡要做法
如果只記住一件事,就是先完成前 20 秒,再生成整支影片。這個測試能看出肖像、音訊長度、嘴部動作與穿插鏡頭風格是否搭得起來。
| 階段 | 要製作的內容 | 重要原因 |
|---|---|---|
| 歌曲段落表 | 標記前奏、主歌、副歌、橋段與純樂器段落 | 避免整支影片只有一張臉唱歌 |
| 歌手素材 | 製作一張清楚肖像並重複使用 | 讓表演者容易辨認 |
| 嘴型同步片段 | 在 Talking Avatar 生成短人聲段落 | 方便發現走樣並替換 |
| 穿插鏡頭 | 使用 Image to Video 製作非嘴部動態畫面 | 遮接剪輯與難同步音節 |
| 時間軸剪輯 | 在 CapCut、Premiere Pro、DaVinci Resolve 或其他剪輯軟體中組合 | 讓整首歌具有連續感 |
AI 能製作完整的嘴型同步音樂影片嗎?
可以,但最好的流程是用較短的片段組成完整影片。一整首歌包含太多歌詞速度、情緒轉折和視覺節拍,很難由單一生成片段流暢承載。
歌手嘴部重要的時刻使用 Talking Avatar,其餘部分則使用動態穿插鏡頭、舞台畫面、角色動作與象徵性視覺。
這樣能保留控制空間。副歌某一句走樣時,只需替換那個段落,不必重新製作整支音樂影片。
像音樂剪輯師一樣規劃歌曲
生成前先聽一遍,標記觀眾應該看到歌手的位置。不是每一句人聲都需要特寫。許多有力的音樂影片,會把臉部鏡頭留給吸耳句、情緒歌詞與副歌。
| 歌曲時刻 | 需要嘴型同步嗎? | 如果不需要,更好的畫面選擇 |
|---|---|---|
| 清楚的副歌吸耳句 | 需要 | 穩定特寫、直視鏡頭、簡單頭部動作 |
| 快速歌詞段 | 視情況 | 手部細節、舞台燈光、城市畫面或象徵物件 |
| 純樂器間奏 | 不需要 | 世界觀畫面、舞蹈片段、運鏡或道具特寫 |
| 充滿情緒的長音 | 需要 | 緩慢特寫,頭部動作極少 |
| 段落之間的轉場 | 不需要 | 遮住剪接點的穿插鏡頭 |
| 重拍爆發 | 通常不需要 | 舞台遠景、觀眾燈光或動作更強的場景 |
這份段落表能避免最終影片滿是唱歌的臉,也能讓每個生成片段有明確任務。
為什麼較短人聲段落更好處理
Talking Avatar 支援準備好的語音或歌唱音訊,以及 DomoAI Text to Speech 的輸出。它也支援 5 秒、10 秒和 20 秒的標準時長,Pro 方案則提供 30 秒和 60 秒快速模式。
表演簡單時,較長的片段會有幫助。音樂影片使用較短的 10–20 秒片段,更容易檢查、替換及用穿插鏡頭遮蓋。只有在人聲旋律線、臉部角度與表情保持受控時,才使用較長片段。
先從副歌吸耳句開始。該段落成功後,再做主歌;若失敗,就先修正肖像、音訊或動作提示詞,再花時間製作其他部分。
嘴型同步前先準備歌手素材
較長的音樂影片需要一位容易辨識的表演者。使用乾淨的人像或角色圖片,讓嘴巴、下顎線、眼睛及頭部角度清楚可見。避免頭髮、麥克風、手或道具遮住嘴巴。
若需要新的來源圖,先製作肖像再進入嘴型同步:
製作用於嘴型同步的原創動漫歌手肖像,直式 4:5。歌手設計:銀髮、琥珀色眼睛、帶藍綠色飾邊的黑色舞台外套、小星星耳環,表情富有情緒,不使用真實名人外貌。鏡頭:正面半身特寫,嘴巴、眼睛與下顎線清楚可見。光線:柔和霓虹藍與紫羅蘭舞台燈,深色演唱會背景,柔和輪廓光。臉部乾淨、無遮擋。不生成文字,不用麥克風遮住嘴巴,不新增角色。
將審核通過的靜態圖存到 Assets,各人聲段落都使用同一來源。若需要更完整的角色流程,可搭配 音樂影片場景中的 AI 角色一致性。
在 Talking Avatar 生成嘴型同步版本
為每段人聲上傳人像,並加入對應的音訊片段。把動作提示詞與歌詞分開。動作提示詞應描述表演、表情和身體動作。
Talking Avatar 動作提示詞:平穩的歌唱表演,臉部置中、嘴部動作清楚、自然眨眼一次、頭部輕微移動、眼神柔和、肩膀稍微擺動;副歌情緒豐富,臉部穩定,不做誇張身體動作。
讓嘴型容易看清楚。臉部靠近、頭部穩定、光線一致,把誇張運鏡留給穿插鏡頭或 Image to Video 畫面。
背景音樂和完整歌曲混音應在匯出後,於 CapCut、Premiere Pro、DaVinci Resolve 或其他剪輯軟體中另外加入。Talking Avatar 能生成臉部表演,但最終歌曲混音應放在剪輯時間軸裡。
用穿插鏡頭處理難同步的歌詞
穿插鏡頭不是填充素材,而是保護剪輯的工具。快速歌詞、氣音音節、純樂器空檔,以及生成片段之間的接點,都可使用。
製作非歌唱鏡頭時,使用 Image to Video。當鏡頭需要電影感動態、氛圍、產品式運動或多鏡頭音樂影片質感時,Seedance 2.0 是自然合適的選擇。
- 握住麥克風的手。
- 舞台燈光亮起。
- 雨中反射的城市燈光。
- 副歌前歌手的背影。
- 專輯封面物件或象徵道具。
- 看不到嘴巴的觀眾遠景剪影。
- 角色走過歌曲場景。
某句歌詞若已大致可用,就保留嘴型同步片段,只覆蓋最弱的兩秒。重新生成優先留給臉部破損、角色外觀走樣,或主要吸耳句嘴型明顯出錯的情況。
全部生成前先做鏡頭段落表
對照歌曲時間軸寫鏡頭表,不需要華麗,只要說清楚哪些秒數需要嘴型同步、哪些秒數需要輔助畫面。
| 時間 | 音訊時刻 | 視覺 | 工具 |
|---|---|---|---|
| 0-4s | 前奏鋪底音色 | 城市屋頂、雨、緩慢推鏡 | Image to Video |
| 4-12s | 主歌第 1 句 | 歌手特寫,平穩演唱 | Talking Avatar |
| 12-18s | 主歌第 2 句 | 握麥克風的手、霓虹光 | Image to Video |
| 18-28s | 副歌吸耳句 | 歌手特寫加舞台遠景切鏡 | Talking Avatar+穿插鏡頭 |
| 28-32s | 重拍爆發 | 觀眾燈光與快速轉場 | Image to Video |
| 32-44s | 橋段 | 側臉,較柔和的表情 | Talking Avatar |
偶像風格或虛擬歌手內容,可參考 虛擬 K-Pop 偶像 AI 產生器,取得更具體的表演者與舞台方向。
維持所有片段的連貫性
來源圖、裁切、光線或表演方向在段落間改變,就可能破壞連貫性。每個 Talking Avatar 版本重用相同已審核肖像,保持構圖與動作/表情提示詞一致,將換裝或角度改變留給刻意安排的穿插鏡頭。
實用的連貫性備註可以這樣寫:
與前一鏡相同的歌手:銀髮、琥珀色眼睛、帶藍綠色飾邊的黑色舞台外套、星星耳環、霓虹藍紫舞台光線;平穩而富有情緒的表演,正面特寫,嘴部清楚可見。
將已審核肖像、穿插鏡頭靜態圖與最終片段放在同一個專案資料夾。後面段落走樣時,先與已通過的第一段副歌比較,再重新生成。
較長歌曲的三軌時間軸
完整生成前,我會先把剪輯分成三軌。雖然基本,卻能區分原本容易全部歸咎於模型的問題。
| 軌道 | 放置內容 | 我的審核規則 |
|---|---|---|
| 人聲表演 | 看得到歌唱嘴型的 Talking Avatar 片段 | 固定已審核肖像、裁切與表演提示詞 |
| 穿插鏡頭 | 手、舞台燈、道具、遠景與轉場 | 覆蓋少數嘴型失誤,不必重做可用版本 |
| 主音軌 | 完成的歌曲混音 | 依此音軌剪輯畫面;不要把生成音訊用作最終混音 |
我會用時間碼為每一組檔案命名,例如 03_chorus_00-12_vocal.wav 和 03_chorus_00-12_avatar_v1.mp4。我盡量在換氣處剪接,並在兩端留一小段餘量。這樣替換剪輯時就輕鬆多了。
更多範例可瀏覽 音樂影片流程資料庫 或 櫻花浪漫音樂影片解析。若嘴型同步是弱點,可將專門的 AI 影片嘴型同步流程 與 AI 嘴型同步工具指南 中的選項比較。
剪輯完整音樂影片時間軸
在剪輯軟體中組合最終作品。先放完整歌曲,再只於需要露臉唱歌的位置加入嘴型同步片段。難同步歌詞與片段接點,使用穿插鏡頭覆蓋。
- 把完整歌曲放到時間軸。
- 加入第一個副歌嘴型同步片段。
- 只在需要看見嘴巴的地方加入主歌嘴型同步片段。
- 在較弱音節、轉場與純樂器段落上方覆蓋穿插鏡頭。
- 一次替換一個效果不佳的片段。
- 使用 Video Upscaler,在匯出前做最後的畫質提升。
匯出前先靜音檢查。如果影片在沒有聲音的情況下仍然說得通,視覺節奏就足以支撐這首歌。
每個段落的審核清單
拼接前先檢查每支片段,不要等整首歌組好才找問題。
| 審核項目 | 檢查內容 | 修正方法 |
|---|---|---|
| 嘴型時間 | 關鍵音節落點接近到讓人感覺是刻意對齊 | 縮短音訊段落或替換片段 |
| 臉部穩定性 | 眼睛、下顎、頭髮與表情保持可辨識 | 重用相同肖像並簡化動作 |
| 鏡頭能量 | 主歌、副歌與橋段不會感覺完全一樣 | 加入穿插鏡頭或更寬的舞台畫面 |
| 轉場穩定性 | 片段邊界不暴露跳接 | 用非嘴部鏡頭覆蓋剪接點 |
| 音訊安排 | 最終歌曲混音乾淨地承接所有片段 | 把最終音樂混音留在剪輯軟體處理 |
更完整的音樂影片規劃,可從 Music Video 情境頁開始。若要了解整套工具,可參考 動漫音樂影片創作的 AI 工具指南。
嘴型同步審核重點
拼接完整時間軸前,檢查每個人聲段落。短段落的替換,比重做整首歌更容易。
嘴型同步逐漸錯位
使用較短的音訊片段,每次檢查一句人聲。只替換效果不佳的片段。
音訊聽起來混濁
準備較清楚的人聲段落供審核,完整音樂混音留到最終剪輯。若人聲被埋住,就增加穿插鏡頭,不要強求持續露出嘴部。
臉在不同片段間改變
重用相同肖像,重述相同角色描述,並讓光線與服裝用語保持一致。
影片太重複
在歌唱特寫之間加入遠景、道具鏡頭、舞台動態與象徵性穿插畫面。
副歌缺乏能量
使用更強烈的穿插鏡頭或舞台遠景。保持臉部穩定,讓場景帶出能量。
常見問題
AI 能製作完整的嘴型同步音樂影片嗎?
可以。用較短的嘴型同步片段、動態穿插鏡頭與最終時間軸剪輯組成,不必嘗試一次生成整首歌。
可以使用 Suno 歌曲嗎?
可以,但要在最終剪輯時使用。不要將 Suno 連結貼到 Talking Avatar。先用準備好的語音或歌唱音訊生成虛擬角色嘴型同步,再到 CapCut、Premiere Pro、DaVinci Resolve 或其他剪輯軟體中加入完整的 Suno 歌曲或背景音樂。
每個鏡頭都應做嘴型同步嗎?
不需要。重要人聲時刻使用嘴型同步,節奏、轉場、純樂器段落及難同步的密集歌詞則使用穿插鏡頭。
每段嘴型同步應該多長?
先用 10–20 秒的片段,方便檢查。Talking Avatar 也支援 5 秒、10 秒和 20 秒的標準時長,Pro 方案提供 30 秒和 60 秒快速模式。
如何讓整支影片都是同一位歌手?
重用相同肖像、重述相同角色描述、保持光線一致,並將每個新片段與已審核的第一段副歌對照。